
Un problème N+1 dans une API GraphQL NestJS apparaît lorsqu'un résolveur de champ imbriqué déclenche une lecture supplémentaire pour chaque élément renvoyé. La query peut sembler rapide tout en exécutant beaucoup trop d'allers-retours vers PostgreSQL, MongoDB ou une API externe.
Tant que le jeu de données est petit et que les dépendances répondent vite, ce défaut reste invisible. Il devient coûteux dès que le catalogue, la latence réseau ou le trafic augmentent.
Dans ce tutoriel, nous allons détecter un N+1 GraphQL dans NestJS avec NestJS Profiler, puis le corriger avec des DataLoaders scopés à la requête, capables de grouper les clés demandées et de dédupliquer les lectures d'une même opération.
Sur l'application d'exemple, cette query interroge 3 systèmes différents. Elle passe de 10 allers-retours à 3 : une requête SQL, une requête MongoDB et un appel HTTP.
En résumé :
- Symptôme : le nombre de requêtes SQL, MongoDB ou HTTP augmente avec le nombre d'éléments renvoyés par la query.
- Cause : chaque résolveur de champ imbriqué charge sa donnée individuellement, sans connaître les autres éléments de la liste.
- Solution : un DataLoader par source de données, scopé à la requête, qui batche et déduplique les clés demandées.
- Résultat : 10 allers-retours ramenés à 3, et un coût qui ne dépend plus du nombre de produits renvoyés.
Qu'est-ce qu'un problème N+1 dans une API GraphQL NestJS ?
Un N+1 apparaît lorsqu'une query récupère une liste, puis qu'un résolveur de champ imbriqué déclenche une lecture supplémentaire pour chaque élément de cette liste.
Dans notre exemple, la query récupère des produits, les reviews associées à chaque produit, puis l'auteur de chaque review :
1 requête  → liste des produits
N requêtes → reviews de chaque produit
M requêtes → auteur de chaque review
Avec 4 produits et 5 reviews, cela donne :
1 + 4 + 5 = 10 allers-retours
Le danger est que le code n'a pas besoin de changer pour que le problème grossisse. C'est la taille du résultat demandé par le client qui décide du nombre de lectures.
Avec 20 produits, notre scénario déclenche 26 allers-retours :
1 requête SQL + 20 requêtes MongoDB + 5 appels HTTP
Un N+1 n'est donc pas forcément une query lente sur un petit jeu de données. C'est surtout une complexité qui évolue avec le nombre d'éléments retournés.
Si vous débutez sur le sujet, GraphQL, kesako ? revient sur le fonctionnement des schémas et des résolveurs, et la mise en place d'une API GraphQL avec Apollo détaille la structuration d'un serveur Node.js.
Le scénario GraphQL utilisé : PostgreSQL, MongoDB et API HTTP
L'application d'exemple de NestJS Profiler simule un backend de marketplace découpé en contextes métier. La query de démonstration est la suivante :
query products {
  products {
    id
    name
    description
    inStock
    price
    createdAt
    reviews {
      id
      author {
        id
        name
        company
      }
      comment
      rating
      createdAt
    }
  }
}
Elle traverse 3 sources de données, une par champ résolu :
| Champ GraphQL | Résolveur | Source de données |
|---|---|---|
products | ProductResolver | PostgreSQL, avec TypeORM ou MikroORM |
Product.reviews | ProductReviewsResolver | MongoDB, avec Mongoose |
Review.author | ReviewAuthorResolver | API HTTP externe d'annuaire utilisateurs |
@Resolver(() => ProductType)
export class ProductReviewsResolver {
  constructor(private readonly loader: ProductReviewsLoader) {}

  @ResolveField(() => [ReviewType])
  reviews(@Parent() product: ProductType): Promise<Review[]> {
    return this.loader.load(String(product.id));
  }
}
@Resolver(() => ReviewType)
export class ReviewAuthorResolver {
  constructor(private readonly loader: ReviewerLoader) {}

  @ResolveField(() => ReviewAuthorType, { nullable: true })
  author(@Parent() review: ReviewType): Promise<Reviewer | null> {
    return this.loader.load(review.authorId);
  }
}
Chaque résolveur est correct pris isolément : il ne connaît que l'élément qu'il doit résoudre. C'est l'exécution combinée de l'arbre GraphQL qui transforme ces lectures individuelles en N+1.
Pour comprendre plus précisément comment NestJS exécute un résolveur et traverse les différentes couches de l'application, consultez le cycle de vie d'une requête NestJS.
Reproduire le N+1 GraphQL localement
Le dépôt contient l'application d'exemple complète. Pour lancer le scénario :
git clone https://github.com/eleven-labs/nest-profiler.git
cd nest-profiler
pnpm install
docker compose up -d
cp examples/api/.env.example examples/api/.env
pnpm example:dev
Le fichier .env.example active les modules nécessaires au scénario :
FEATURE_GRAPHQL=true
FEATURE_MONGOOSE=true
FEATURE_DATALOADER=false
Le flag FEATURE_DATALOADER=false est volontaire : nous commencerons par observer le comportement non optimisé, puis nous le basculerons à true.
Une fois l'application démarrée :
http://localhost:3000/graphqlouvre Apollo Sandbox.http://localhost:3000/_profilerouvre NestJS Profiler.http://localhost:3000/apiouvre Swagger pour explorer le reste de l'exemple.
Envoyez la query products depuis Apollo Sandbox. Pour brancher le profiler sur votre propre application NestJS, la page Getting started décrit l'installation complète.
Comment détecter un N+1 GraphQL dans NestJS avec le profiler
NestJS Profiler associe un token à chaque exécution. Après la query GraphQL, les headers de réponse permettent de retrouver directement le profil concerné :
X-Debug-Token: ebab37ec-3ace-4569-8890-8360ee9e0d3a
X-Debug-Token-Link: /_profiler/ebab37ec-3ace-4569-8890-8360ee9e0d3a
Ouvrez X-Debug-Token-Link, ou accédez à /_profiler puis filtrez les profils GraphQL.
NestJS Profiler rassemble les informations techniques d'une même exécution : opération GraphQL, trace d'exécution, requêtes SQL et MongoDB, appels HTTP sortants, logs et exceptions. Ici, l'important est de commencer par la trace d'exécution, puis de confirmer les répétitions dans les panneaux de détail. Ce qu'il collecte sur une opération GraphQL est décrit dans le package @eleven-labs/nest-profiler-graphql.
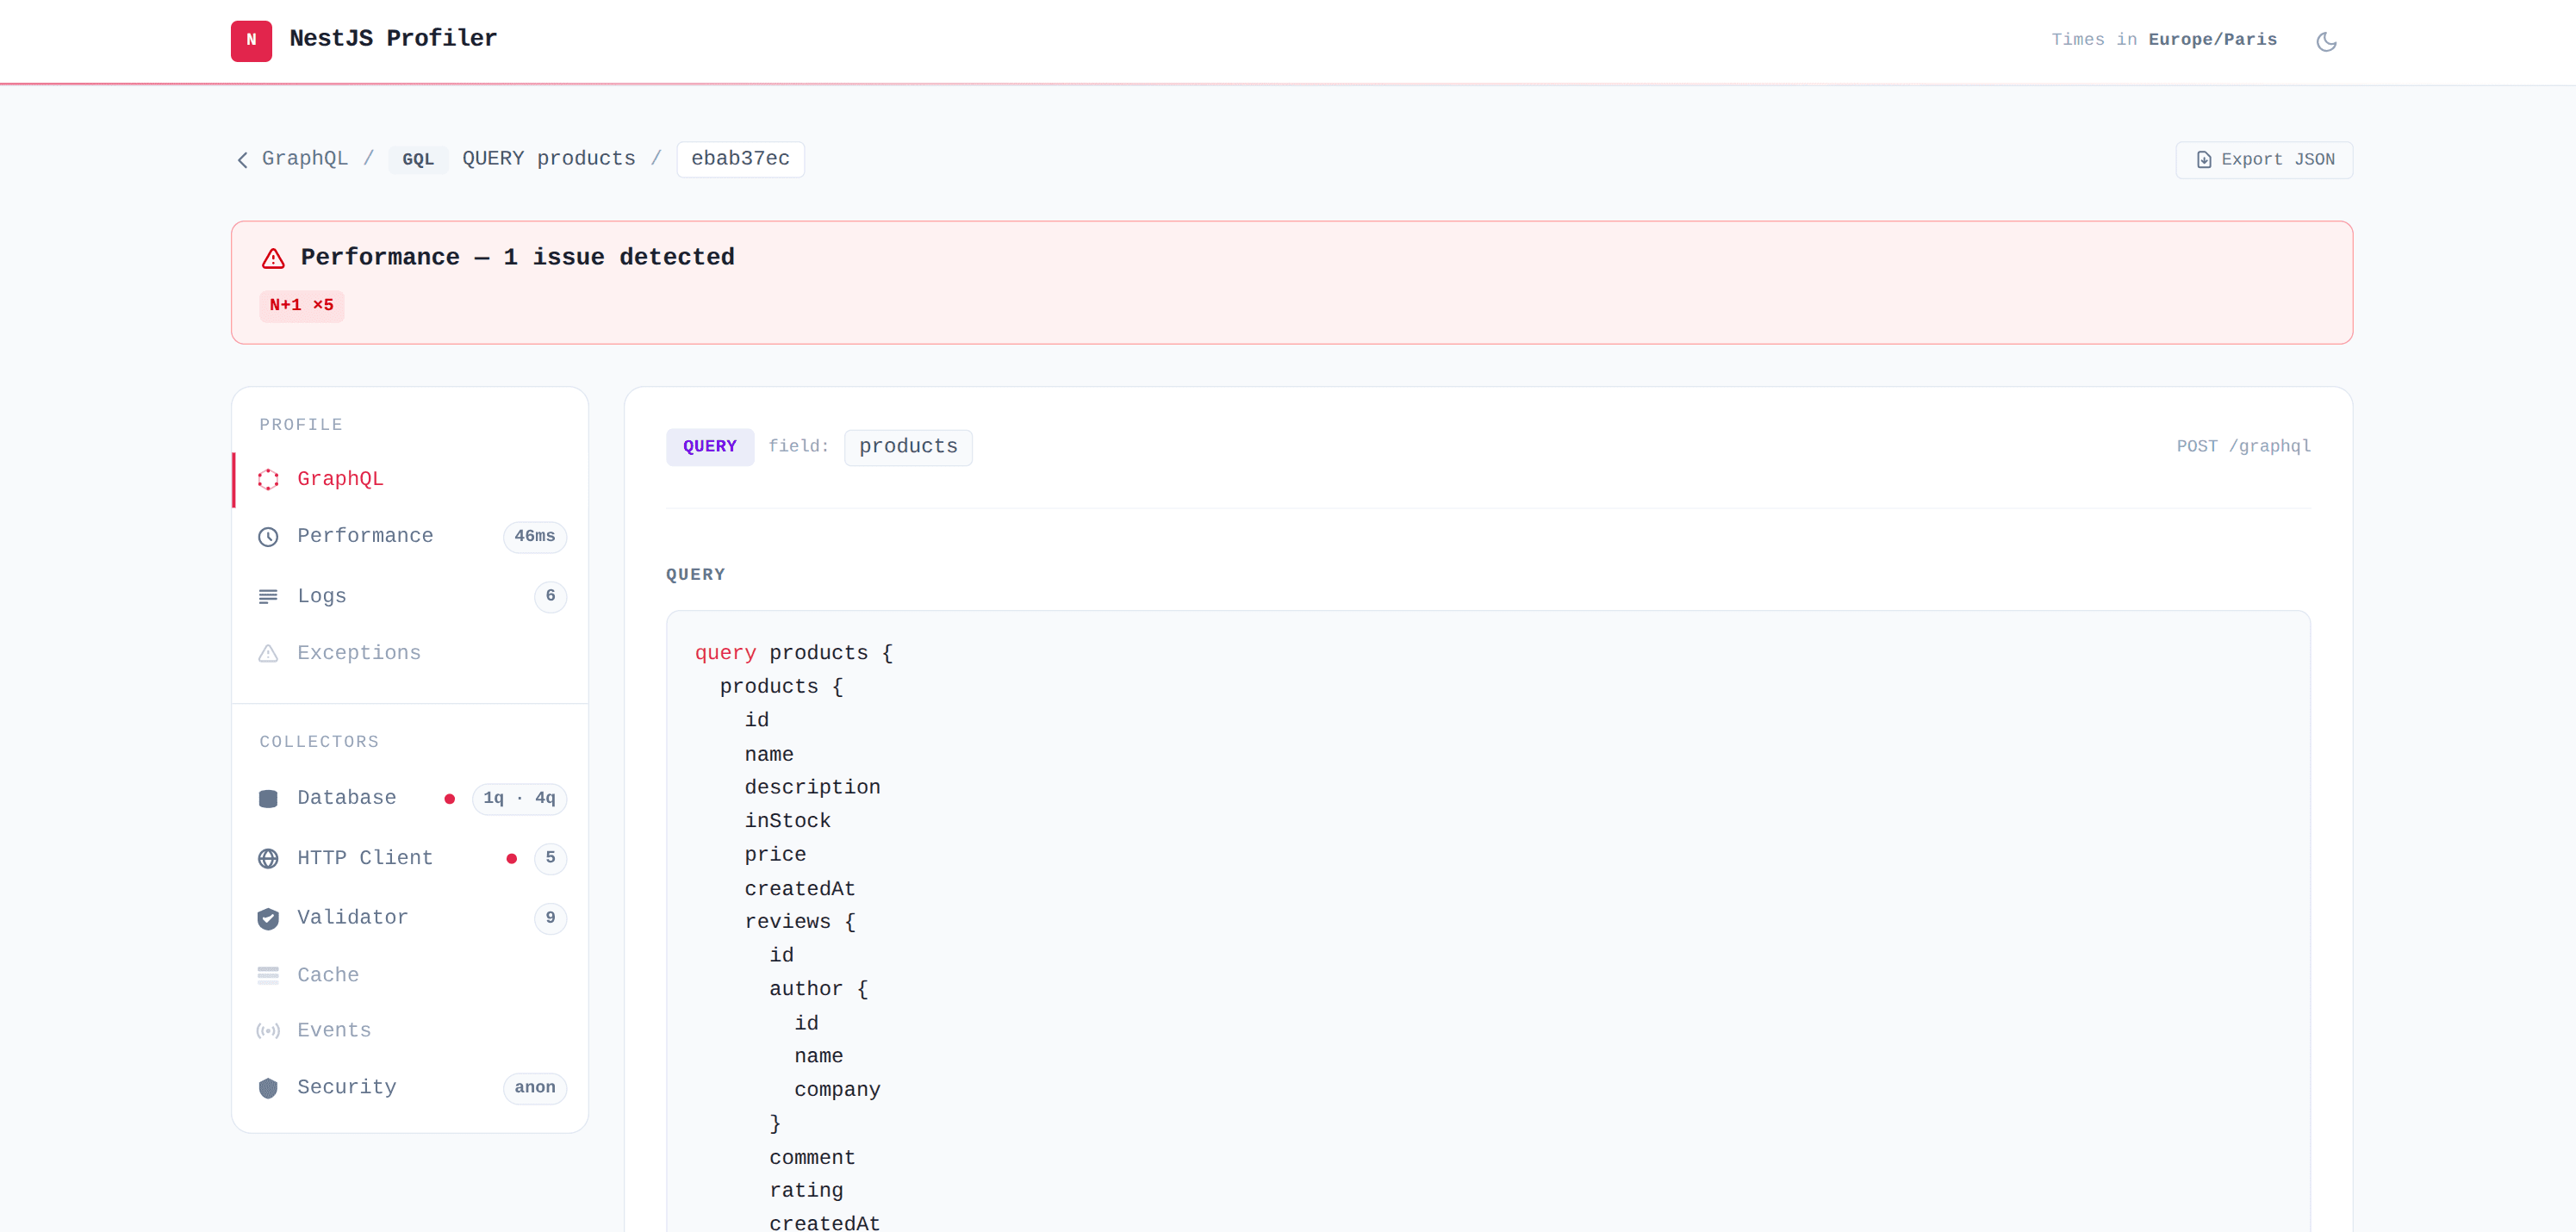
Lire l'execution trace d'une opération GraphQL
L'onglet Performance affiche une execution trace qui remet les événements dans leur ordre d'exécution. Avec le filtre I/O only, elle ne conserve que les opérations qui sortent du processus : SQL, MongoDB, HTTP, cache et autres dépendances externes. L'ensemble des panneaux est décrit dans la documentation de l'interface du profiler.
Dans le profil initial, la trace fait apparaître :
- 1 requête SQL.
- 4 requêtes MongoDB
find. - 5 appels HTTP sortants.
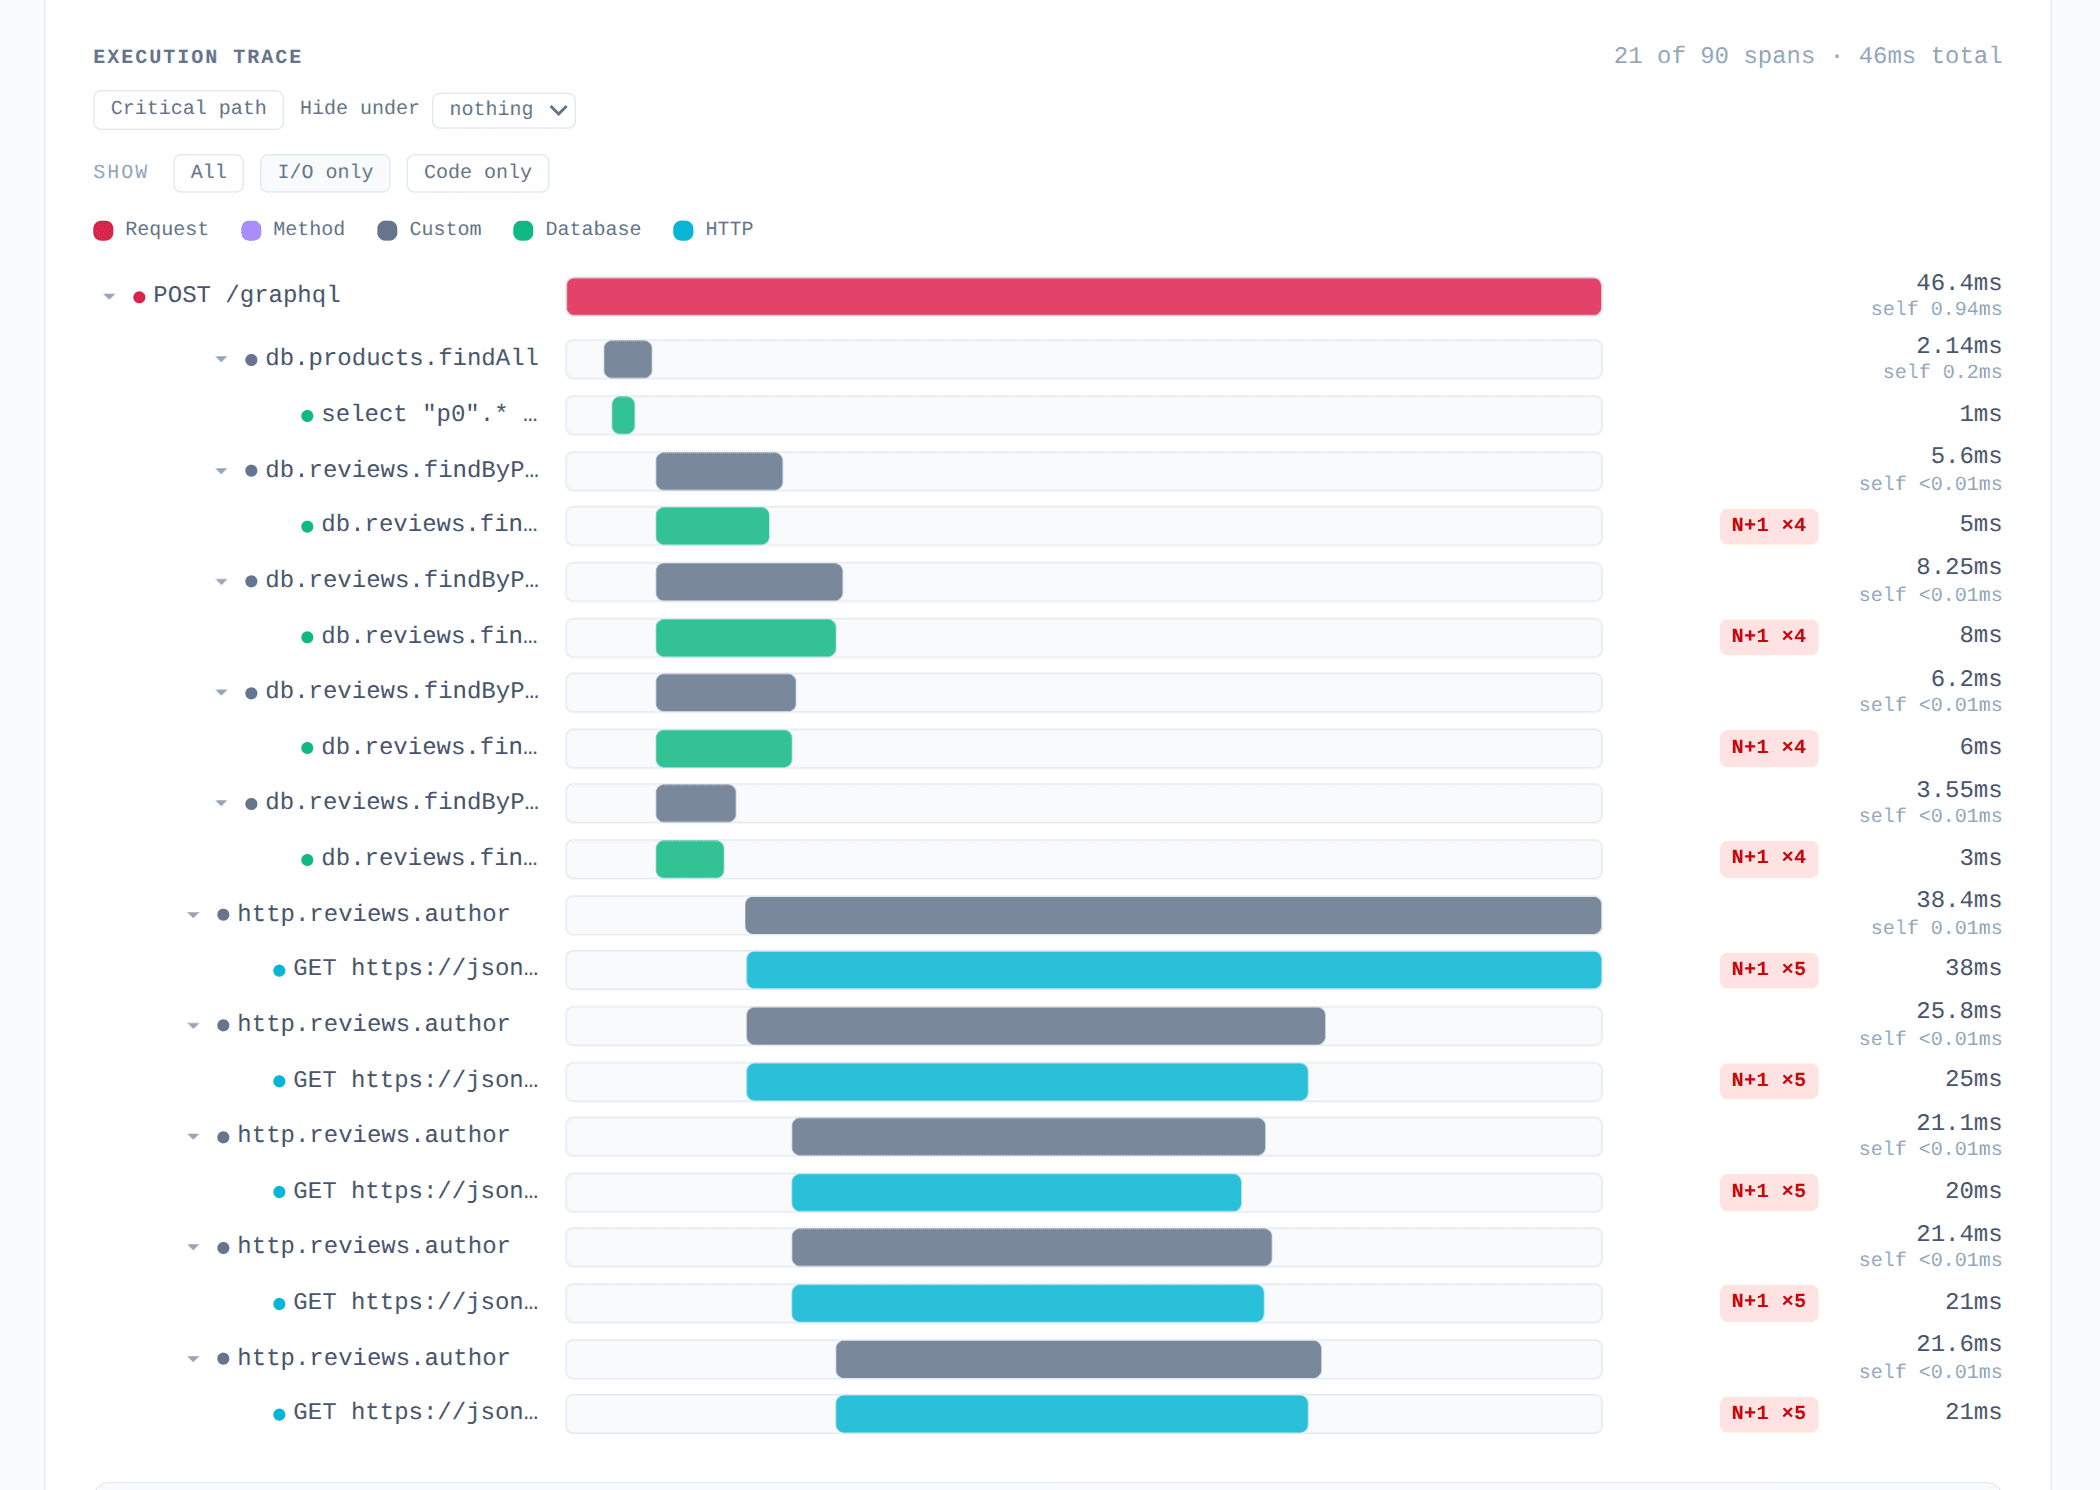
La répétition se voit immédiatement : 4 opérations MongoDB similaires, puis 5 appels vers l'annuaire externe. Les 2 étages se recouvrent partiellement, car chaque appel HTTP démarre dès que les reviews de son produit sont revenues, sans attendre les autres.
La trace permet aussi de distinguer 2 notions souvent confondues :
- Les appels HTTP partent en parallèle ; cela limite la latence visible localement.
- Ils restent malgré tout trop nombreux ; ils consomment des connexions, du budget de rate limiting et des ressources chez la dépendance externe.
N+1 sur MongoDB : 4 lectures des reviews
Le panneau Database, sous-onglet MongoDB, confirme que le résolveur Product.reviews déclenche une opération find par produit. Ces requêtes sont collectées par le package @eleven-labs/nest-profiler-mongoose.
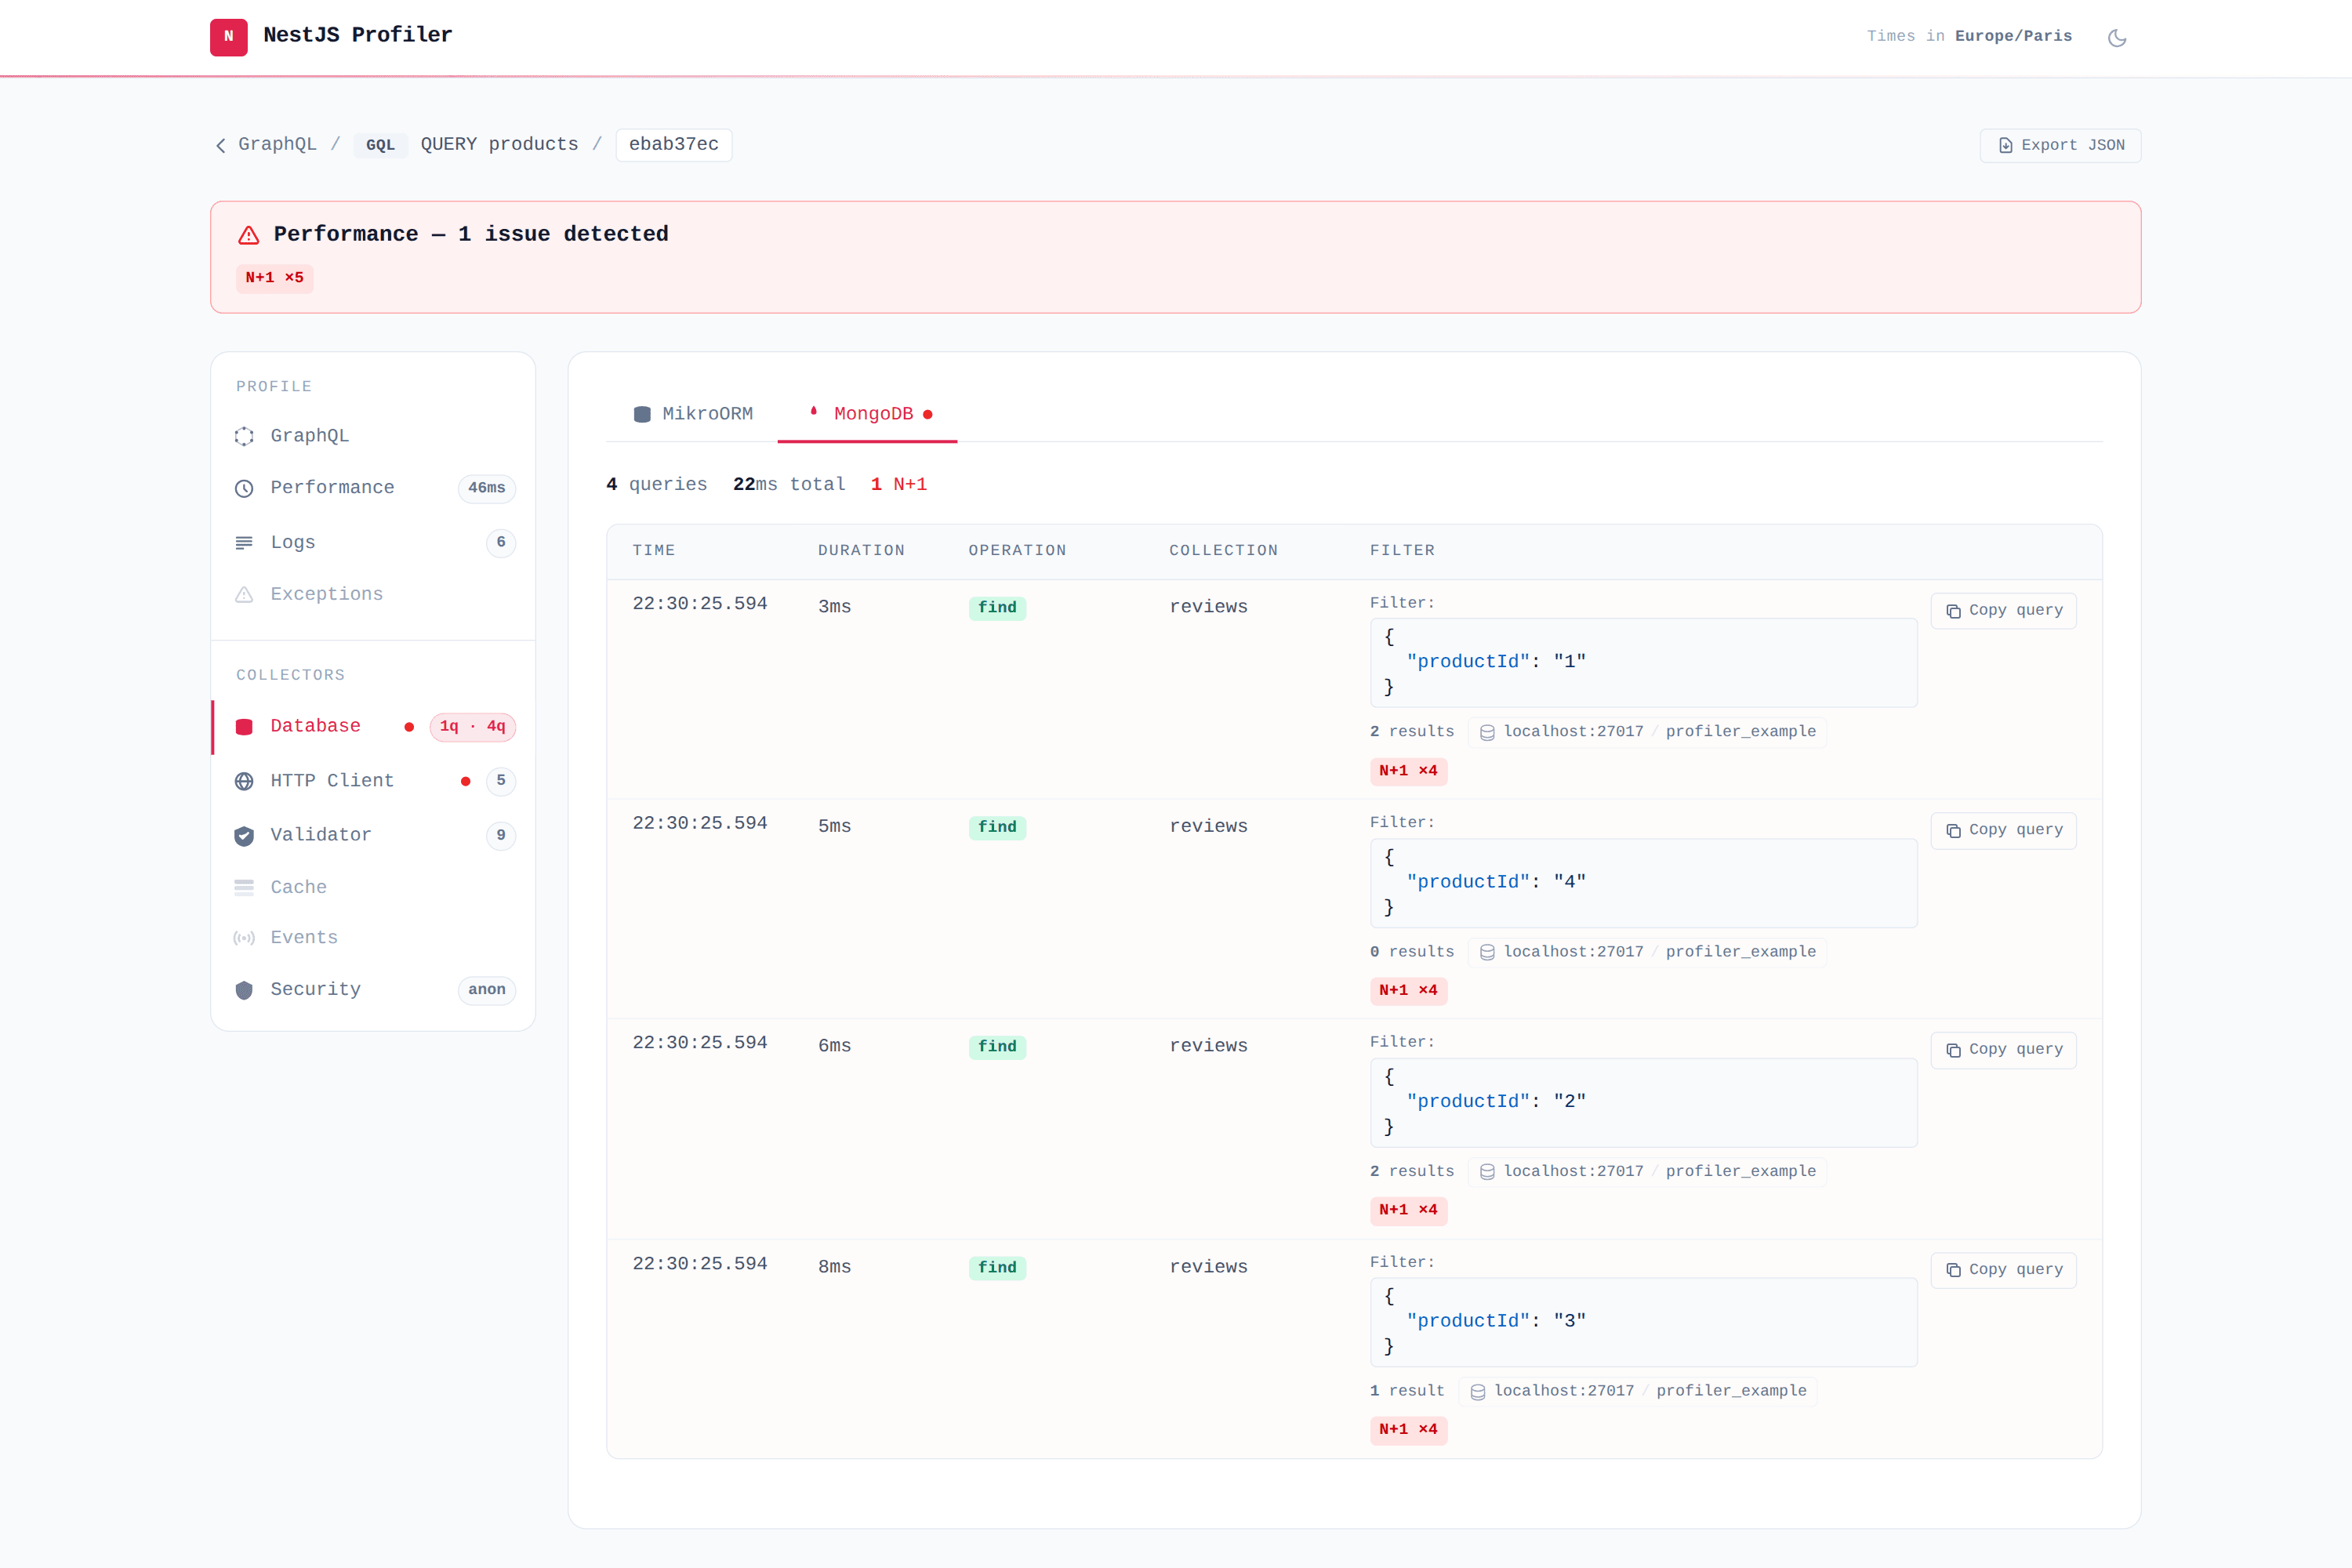
Chaque ligne indique notamment :
- La collection interrogée.
- Le type d'opération.
- Le filtre.
- La durée.
- Le nombre de documents retournés.
Une des requêtes de l'exemple ne retourne aucun avis. Elle reste pourtant un aller-retour complet vers MongoDB. Plus le catalogue grandit, plus ce coût augmente.
N+1 sur une API externe : 5 appels HTTP vers les auteurs
Le panneau HTTP Client montre les appels effectués par Review.author. Ces appels sont collectés par le package @eleven-labs/nest-profiler-http.
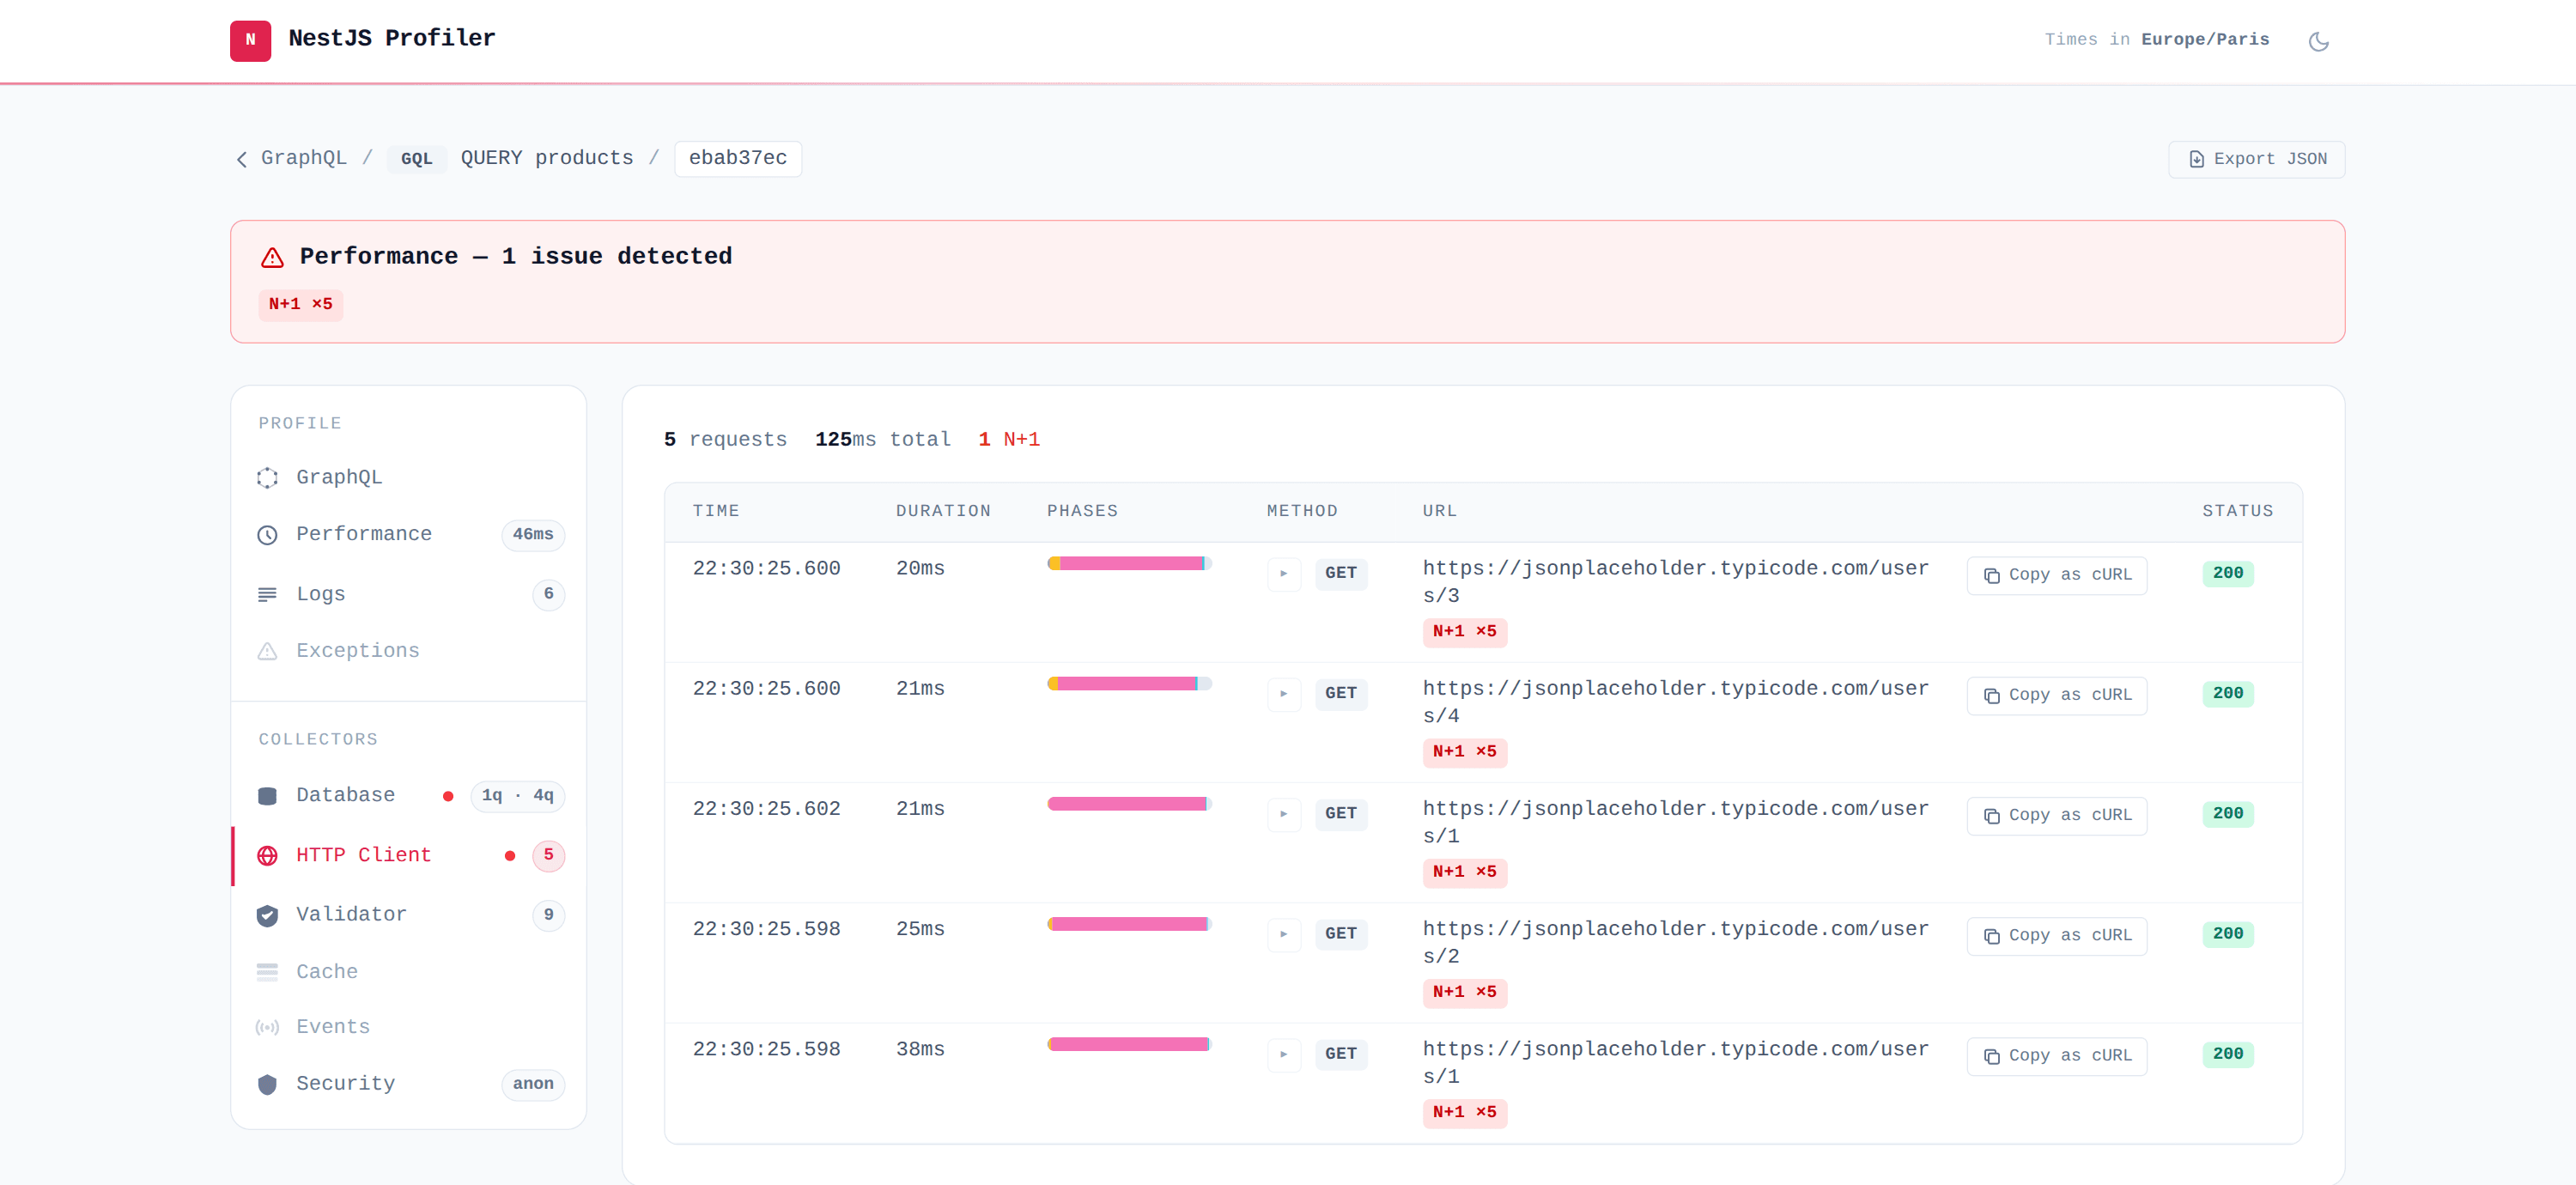
Les 5 appels relèvent d'un problème de batching : l'API externe est interrogée individuellement pour chaque auteur.
Mais le profil révèle aussi un doublon : /users/1 est demandé 2 fois pendant la même opération GraphQL. C'est un problème de déduplication.
Ces 2 problèmes appellent une même solution dans notre cas : un DataLoader scopé à la requête, capable de grouper les clés et de mémoriser celles déjà demandées.
Corriger un N+1 GraphQL NestJS avec DataLoader
DataLoader collecte les clés demandées pendant la même phase de résolution GraphQL, puis appelle une fonction de batch avec l'ensemble de ces clés.
Il apporte 2 bénéfices dans notre scénario :
- Le batching : plusieurs produits ou auteurs sont chargés dans une seule requête.
- La déduplication : une même clé demandée 2 fois n'est chargée qu'une fois pendant la même opération GraphQL.
Avant : un loader direct
La stratégie initiale appelle le service à chaque résolution :
@Injectable()
export class DirectProductReviewsLoader implements ProductReviewsLoader {
  constructor(private readonly reviews: ReviewService) {}

  load(productId: string): Promise<Review[]> {
    return this.reviews.findByProduct(productId);
  }
}
Chaque produit entraîne donc son propre find({ productId }).
Après : un DataLoader NestJS pour batcher les relations
La version DataLoader collecte les identifiants de produits et appelle une unique méthode findByProducts() qui construit un filtre MongoDB avec $in.
@Injectable({ scope: Scope.REQUEST })
export class DataLoaderProductReviewsLoader implements ProductReviewsLoader {
  private readonly loader: DataLoader<string, Review[]>;

  constructor(reviews: ReviewService) {
    this.loader = new DataLoader<string, Review[]>(async (productIds) => {
      const found = await reviews.findByProducts(productIds);
      const byProduct = new Map<string, Review[]>();

      for (const review of found) {
        const current = byProduct.get(review.productId);

        if (current) {
          current.push(review);
        } else {
          byProduct.set(review.productId, [review]);
        }
      }

      return productIds.map((productId) => byProduct.get(productId) ?? []);
    });
  }

  load(productId: string): Promise<Review[]> {
    return this.loader.load(productId);
  }
}
Le contrat de DataLoader
Le tableau retourné doit garder le même ordre que les clés demandées : une position du tableau correspond à une clé donnée, même lorsqu'aucun résultat n'est trouvé. C'est la source d'erreur la plus fréquente lors de l'écriture d'une fonction de batch.
Dédupliquer les appels HTTP avec un second DataLoader
Batcher les reviews est aussi ce qui permet de batcher les auteurs : quand toutes les reviews sont disponibles dans la même phase de résolution, les identifiants d'auteurs peuvent être regroupés par un second DataLoader.
Sans DataLoader :
products → reviews(product 1) → authors(product 1)
         → reviews(product 2) → authors(product 2)

Avec DataLoader :
products → reviews(product 1, 2, 3, 4)
         → authors(1, 2, 3, 4)
Voici une implémentation type pour ce second loader :
@Injectable({ scope: Scope.REQUEST })
export class DataLoaderReviewerLoader implements ReviewerLoader {
  private readonly loader: DataLoader<number, Reviewer | null>;

  constructor(private readonly reviewers: ReviewerService) {
    this.loader = new DataLoader<number, Reviewer | null>(async (authorIds) => {
      const authors = await this.reviewers.findByIds([...authorIds]);
      const byId = new Map(authors.map((author) => [author.id, author]));

      return authorIds.map((authorId) => byId.get(authorId) ?? null);
    });
  }

  load(authorId: number): Promise<Reviewer | null> {
    return this.loader.load(authorId);
  }
}
Les 2 loaders sont déclarés avec @Injectable({ scope: Scope.REQUEST }), et ce n'est pas un détail : le cache de DataLoader est ainsi limité à l'opération en cours. Il évite les appels dupliqués dans cette opération sans conserver des résultats obsolètes, ni réutiliser des données dans un autre contexte utilisateur ou d'autorisation.
Activer le scénario DataLoader
Dans examples/api/.env :
FEATURE_DATALOADER=true
Relancez ensuite l'application, envoyez exactement la même query et ouvrez le nouveau profil avec son X-Debug-Token-Link.
Mesurer les performances GraphQL avant et après DataLoader
La correction n'est terminée que lorsqu'elle est vérifiée sur la même opération.
Après activation de DataLoader, l'execution trace ne montre plus que :
- 1 requête SQL.
- 1 requête MongoDB avec un filtre
$in. - 1 appel HTTP groupé.
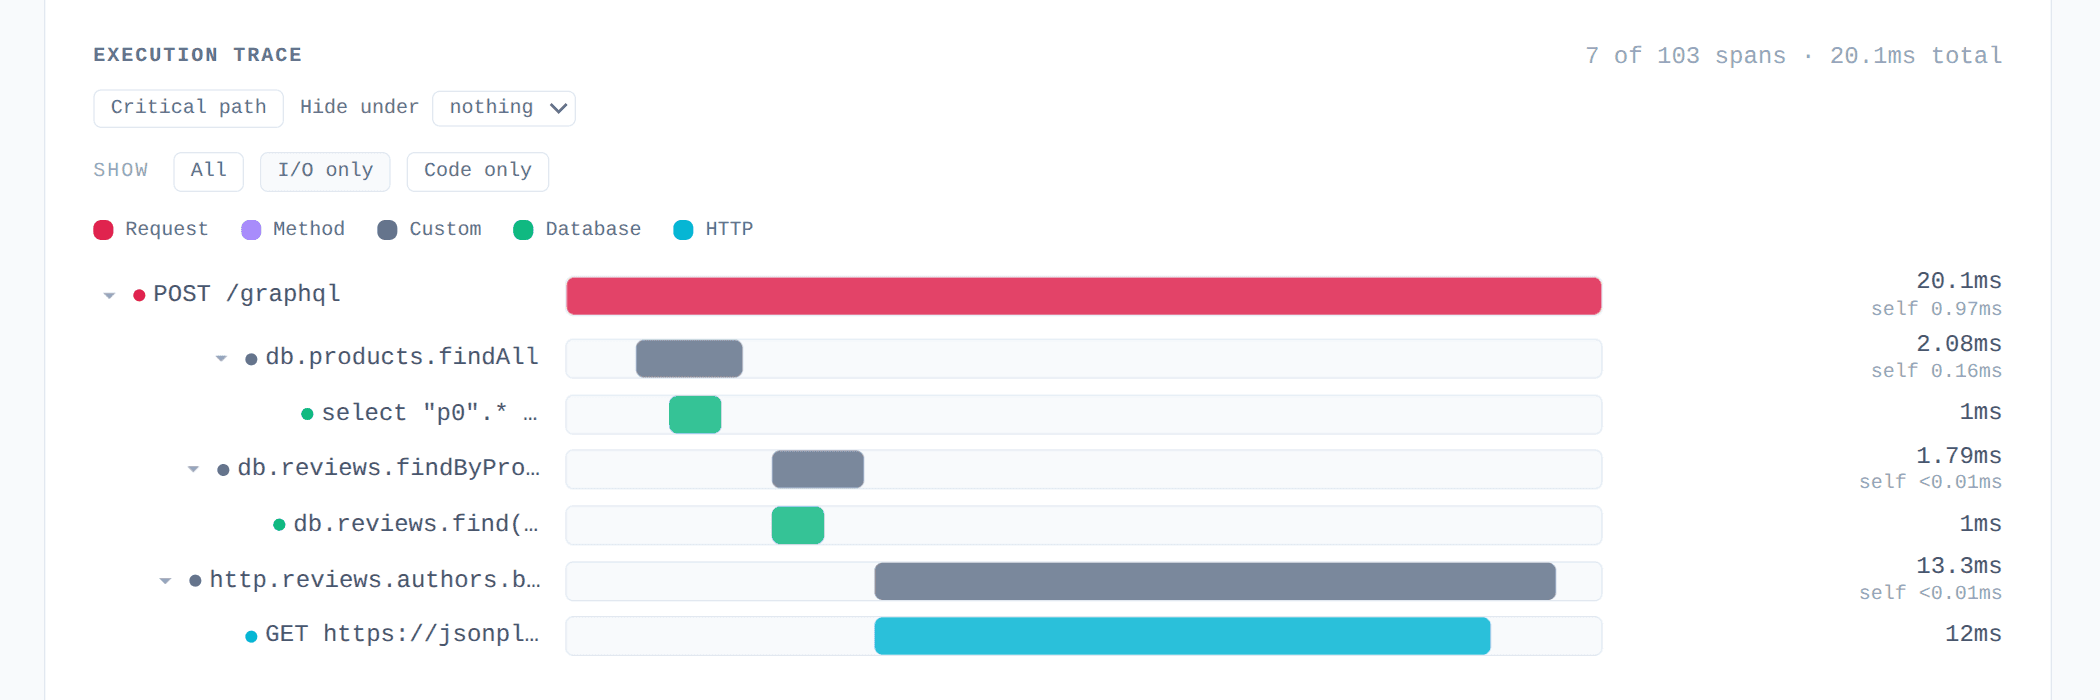
Les tags N+1 disparaissent du profil.
| Avant DataLoader | Après DataLoader | |
|---|---|---|
| Requêtes SQL | 1 | 1 |
| Requêtes MongoDB | 4 | 1 |
| Appels HTTP sortants | 5 | 1 |
| Total des allers-retours | 10 | 3 |
| Tags de performance | N+1 ×4, N+1 ×5 | Aucun |
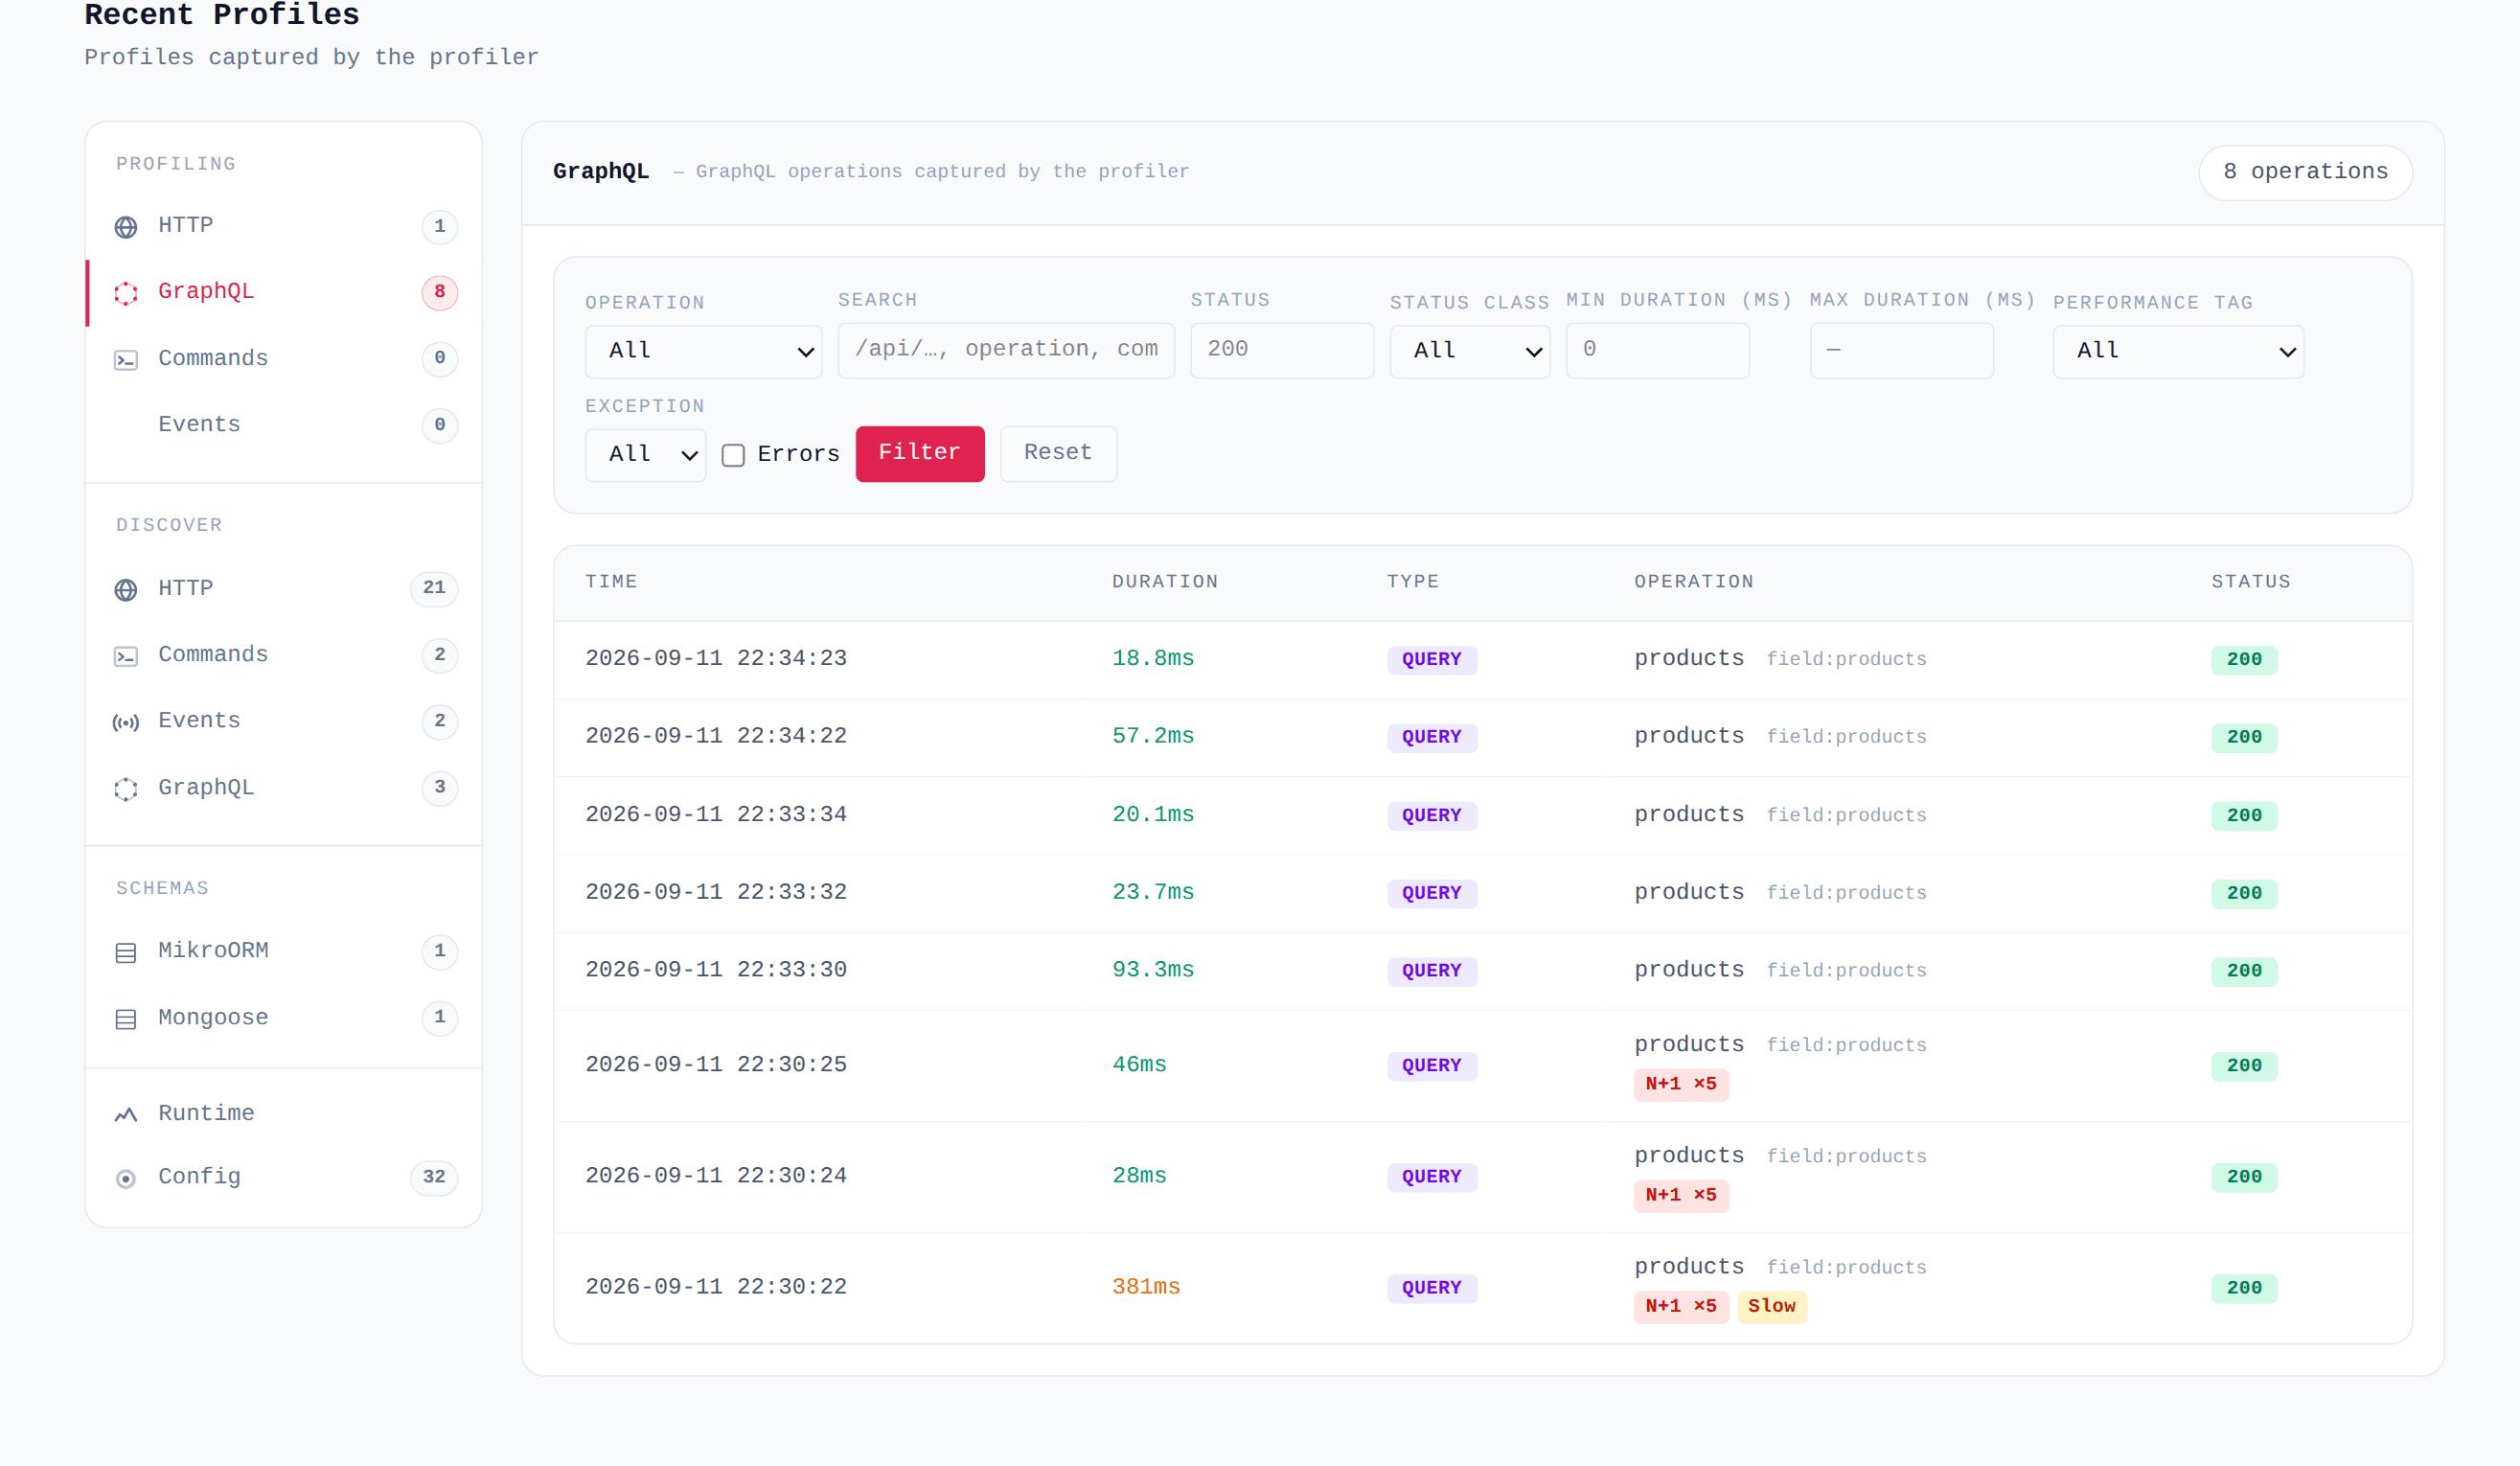
Le gain se lit surtout à l'échelle. Avec 4 produits, la query passe de 10 allers-retours à 3. Avec 20 produits, elle passerait de 26 à 3.
Le résultat important est structurel : le nombre d'accès à MongoDB ne dépend plus du nombre de produits renvoyés, et les appels HTTP sont regroupés et dédupliqués.
DataLoader, jointure ou cache : quelle solution au N+1 GraphQL ?
DataLoader est adapté lorsqu'une opération GraphQL résout plusieurs clés individuelles et que la source de données peut répondre à ces clés en lot.
DataLoader n'est pas un cache applicatif
Son objectif est de limiter les lectures répétées à l'intérieur d'une même opération GraphQL. Pour partager des données entre plusieurs requêtes, il faut un cache applicatif avec sa propre stratégie d'invalidation.
Dans d'autres cas, une autre approche peut être plus pertinente :
| Situation | Approche à privilégier |
|---|---|
| Relation SQL connue avant l'exécution | Jointure, relations, populate ou requête dédiée |
| Même donnée demandée entre plusieurs requêtes HTTP | Cache applicatif avec TTL |
| API externe sans endpoint de batch | Cache par requête pour dédupliquer les appels |
| Très grand nombre de résultats | Pagination, limitation de profondeur ou query complexity |
| Query lente sans requêtes répétées | Index, EXPLAIN, optimisation SQL ou MongoDB |
| Données dépendantes des droits de l'utilisateur | Loader scopé à la requête et clés incluant le contexte nécessaire |
Questions fréquentes
Comment détecter un N+1 dans une API GraphQL NestJS ?
Il faut compter les lectures réellement émises pendant une opération, et non seulement lire les résolveurs. NestJS Profiler regroupe les requêtes répétées par empreinte et les marque dans la trace ainsi que dans les panneaux Database ou HTTP Client.
Comment implémenter un DataLoader dans NestJS avec GraphQL ?
Le plus simple dans NestJS est de créer un provider @Injectable({ scope: Scope.REQUEST }) qui instancie le DataLoader dans son constructeur, expose une méthode load() et se fait injecter dans le résolveur de champ. Le scope requête remplace l'approche consistant à attacher les loaders au contexte GraphQL : NestJS crée une instance par requête et l'injection reste standard.
Un DataLoader suffit-il à corriger tous les N+1 ?
Non. Il faut que la source puisse servir plusieurs clés en une fois. Sans endpoint de batch côté API externe, un DataLoader peut toujours dédupliquer une même clé, mais il ne peut pas réduire plusieurs clés distinctes à un seul appel.
DataLoader ou jointure SQL : que choisir ?
Quand la relation vit dans la même base et que vous savez avant l'exécution qu'elle sera demandée, une jointure, un relations TypeORM ou un populate reste plus direct. DataLoader devient intéressant lorsque le champ est optionnel dans le schéma, lorsque les données viennent de sources différentes, ou lorsque plusieurs résolveurs demandent les mêmes clés pendant la même opération.
Pourquoi les loaders doivent-ils être scopés à la requête ?
Le cache interne de DataLoader est conçu pour la durée d'une opération GraphQL. Un loader partagé entre requêtes risque de réutiliser des données obsolètes, de retenir inutilement de la mémoire ou de mélanger des contextes d'autorisation.
NestJS Profiler peut-il être utilisé en production ?
NestJS Profiler est principalement conçu pour le développement et les environnements contrôlés. Les profils peuvent inclure des URLs, paramètres, payloads, logs, erreurs ou données de sécurité. Activez-le conditionnellement et ne rendez pas son interface accessible publiquement.
Quelle différence entre NestJS Profiler, OpenTelemetry et un APM ?
Un APM et OpenTelemetry servent généralement à suivre l'état d'un système déployé dans la durée. NestJS Profiler est orienté développement : il permet d'examiner une exécution précise dans son contexte complet, puis de rejouer le scénario après une modification. Les approches sont complémentaires.
Tester NestJS Profiler
NestJS Profiler est un projet open source inspiré du Symfony Web Profiler. Il permet de visualiser une exécution NestJS dans /_profiler et d'y relier des collecteurs modulaires : GraphQL, TypeORM, MikroORM, Mongoose, HTTP, cache, validation, sécurité, logs, RabbitMQ, CLI et plus encore.
Pour aller plus loin :
- Découvrir NestJS Profiler
- Installer NestJS Profiler dans une application NestJS
- Profiler les opérations GraphQL avec le package dédié
- Explorer l'application d'exemple
- Tester la démo en ligne
- Accéder au dépôt GitHub
Un N+1 n'est pas forcément visible dans les temps de réponse locaux. En revanche, il laisse une trace : des appels répétitifs que personne n'a écrits explicitement, mais que NestJS Profiler rend visibles.
Avec 1 query, 2 profils et des DataLoaders, vous pouvez passer d'une intuition à une optimisation mesurée.


